什麼是會議知識庫?開會紀錄自己長成團隊記憶
目錄
一家天天開會的公司,仍然可能是一家什麼都不記得的公司。證據就在你的雲端硬碟裡:幾百份會議筆記,每一份都是為某一場會而寫、歸檔在某一個日期底下、之後幾乎沒有人再讀。資訊沒有消失——當下確實有人記了下來。缺的是把「記錄」變成「知識」的那一段:連結、更新、找得到。筆記做不到這些,因為筆記以「會議」為單位組織;而知識是以「主題」為單位存在的。
這個錯位就是整個故事。筆記寫得再好也繞不出來,因為問題從來不在筆記的品質。這篇文章要談的,是從結構上解決這件事的產品類別——AI meeting wiki(會議知識庫)——以及當錄音器自己幫你長出一座知識庫時,它實際上看起來是什麼樣子。
會議筆記的天花板
先說筆記做得到的事。一場會議裡認真的記錄者,產出的是真正的東西:決議、負責人、下一步,偶爾加上一句當下關鍵的原話。在二十四小時內,這份筆記是極好的。問題從第二天開始,而且會複利:
- 筆記以場為單位,問題卻以主題為單位。 當你問「我們和某公司後來怎麼談定價的?」,沒有任何一份筆記包含答案。事實攤在三個月裡的六場會議中,唯一把它們串起來的索引,是某位剛好在場的人的記憶。
- 下一場會議一開,上一份筆記就過期了。 週二的決議週四被翻案,但沒有人回頭改週二的筆記。事後讀它,你會被正確地誤導。筆記是快照;事實需要的是持續編輯。
- 歸檔是人力稅,所以永遠沒人繳。 任何等著會後有人來貼標籤、建連結、重新歸檔的知識系統,都在設計自己的荒廢。會一結束、下一場開始,知識庫資料夾就停在原地。
- 筆記只記下記錄者當下已經理解的事。 它偏向寫筆記的人進會議室前相信的東西。有人低聲讓步的那句話、報出數字前的那一秒遲疑——這些日後真正改變決策的訊號,恰恰沒有人寫下來。
這些都不是反對做筆記的理由,而是指出:筆記無論多好,都只是原料——而幾乎每個團隊都把原料當成品在用。
「AI meeting wiki」是什麼意思
AI meeting wiki(會議知識庫)是一座由你的會議自己書寫、自己維護的知識庫。剝掉產品名,這個類別由三個性質定義:
- 一個主題一頁,不是一場會議一頁。 你見過的每個人、每家公司、每個反覆出現的主題,各自累積成一頁——是連續的脈絡,不是碎片。
- 會議一落地,頁面就更新。 新決議在通話結束幾分鐘後自動歸位到正確的頁面上。沒有人需要歸檔任何東西;結構自己維持自己。
- 每句話都回得到出處。 知識庫頁面上的一句主張,不是憑空生成的摘要——它帶著自己長出來的那一行字、那一場會。這是 wiki 和「拿你的文件聊天的機器人」之間的差別。
搜尋的性質也變了。你不再是跨資料夾挖關鍵字,而是直接查主題本身,結果帶著每一筆命中當初的那句原文。
這座 wiki 怎麼自己長出來
整條流程三個階段,只有第一個需要你。
錄下會議。 錄音發生在你的機器上——沒有任何東西加入通話、參與者清單不多一個人、其他人的體驗完全不變。同一套錄音流程涵蓋你團隊實際開會的所有地方:瀏覽器分頁、桌面版會議軟體、擴音進房間的電話。
轉成逐字稿。 音訊變成帶時間戳、分好說話者的逐字稿,20+ 種語言自動偵測,一句話裡滑進另一種語言也撐得住。
讓 wiki 長大。 從這裡開始,它不再是筆記工具。每份逐字稿落地時,系統會抽出誰出現了、哪些公司和主題被提到、它們的故事變了什麼——然後像一位勤奮的分析師那樣編輯那些頁面:新決議寫入、未結項目往下帶、最後見面日期更新。
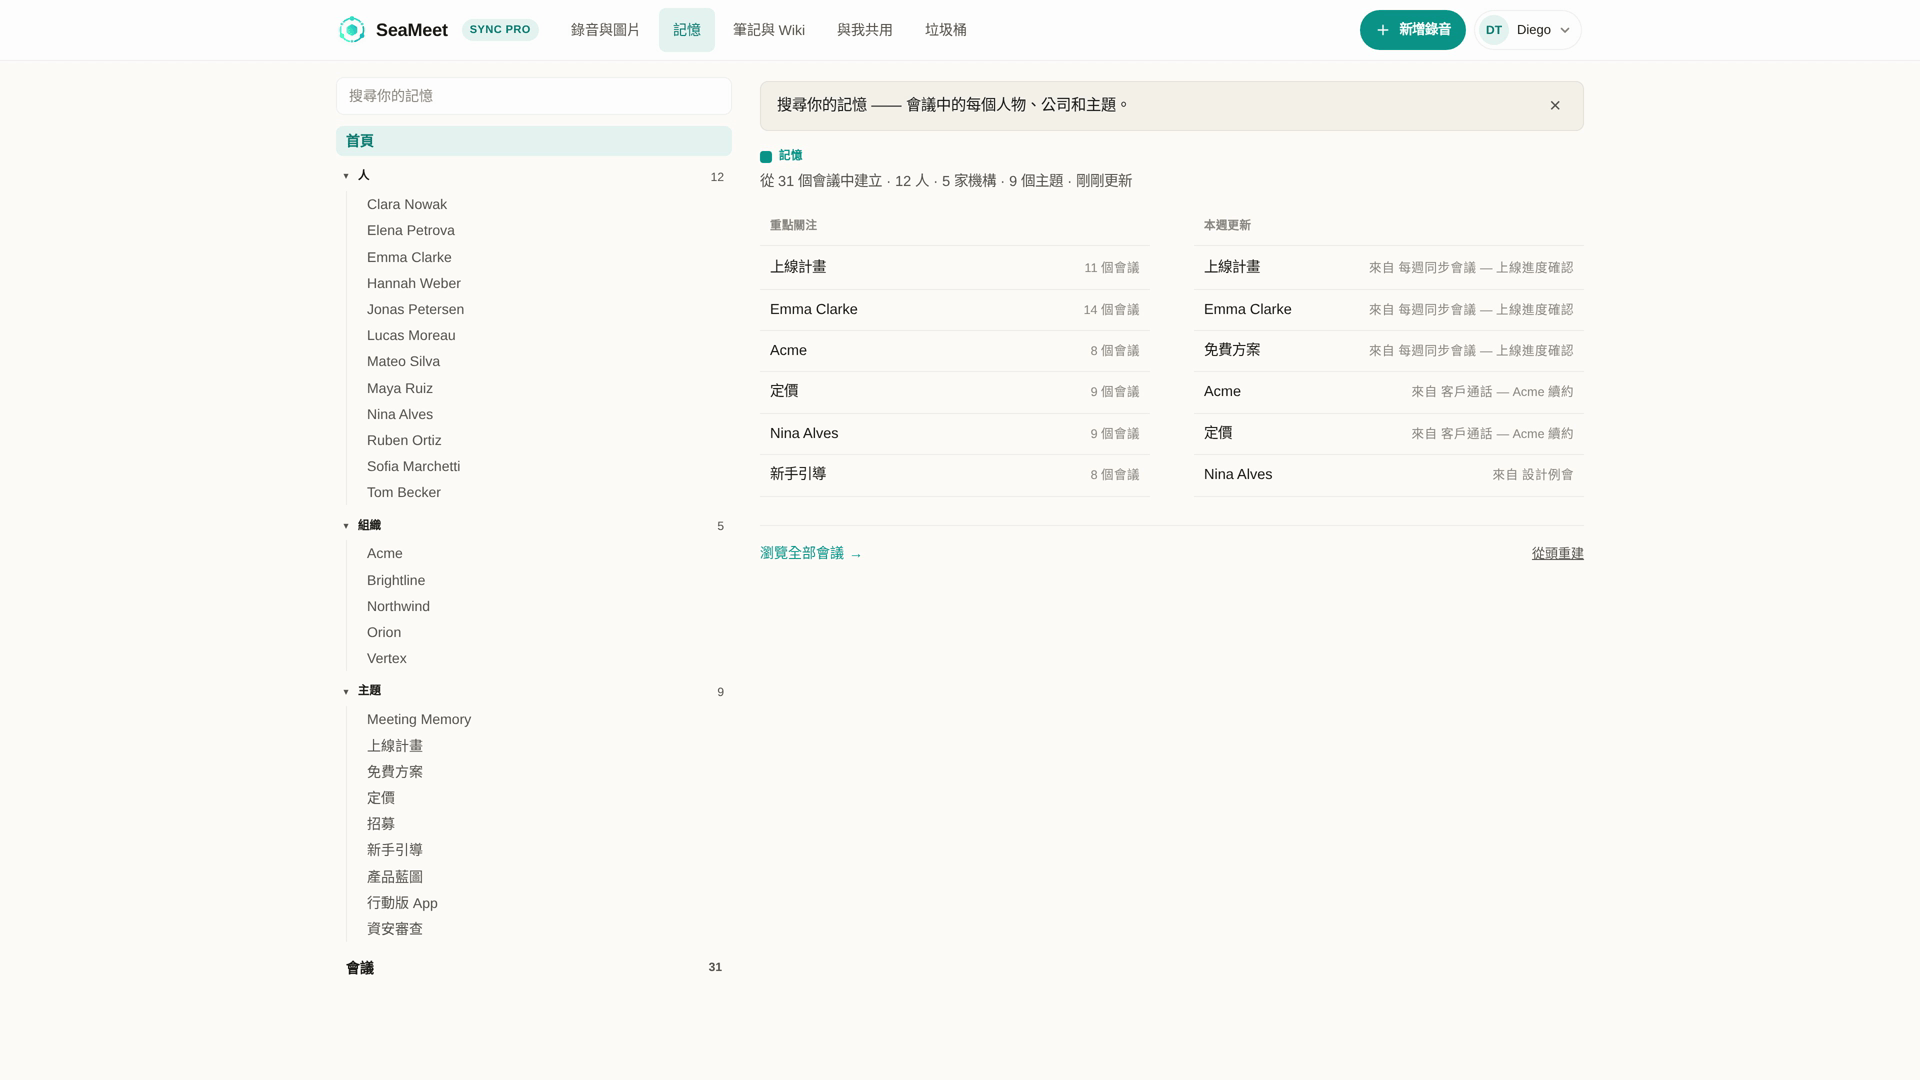
首頁讀起來像一份你從不必委託別人做的主管摘要:現在的重點是什麼、這週哪些頁面動過——每一列都標著是哪一場會議讓它動的。
SeaMeet 長出來的 wiki
具體來說,SeaMeet 裡這件事由兩個互不干擾的表面構成。
Meeting Memory 是從會議長出來的那一半。一個人一頁——你們談過什麼、哪些事還沒結、上次見面是什麼時候。一家公司一頁,由每一場提到它的會議累積而成。一個主題一頁,接住那些一直回來的線頭。每場會議結束後頁面自己改寫;每週一封摘要信列出什麼變了、是哪幾場會議造成的——就算你不主動來查,wiki 也會自己走到你面前。
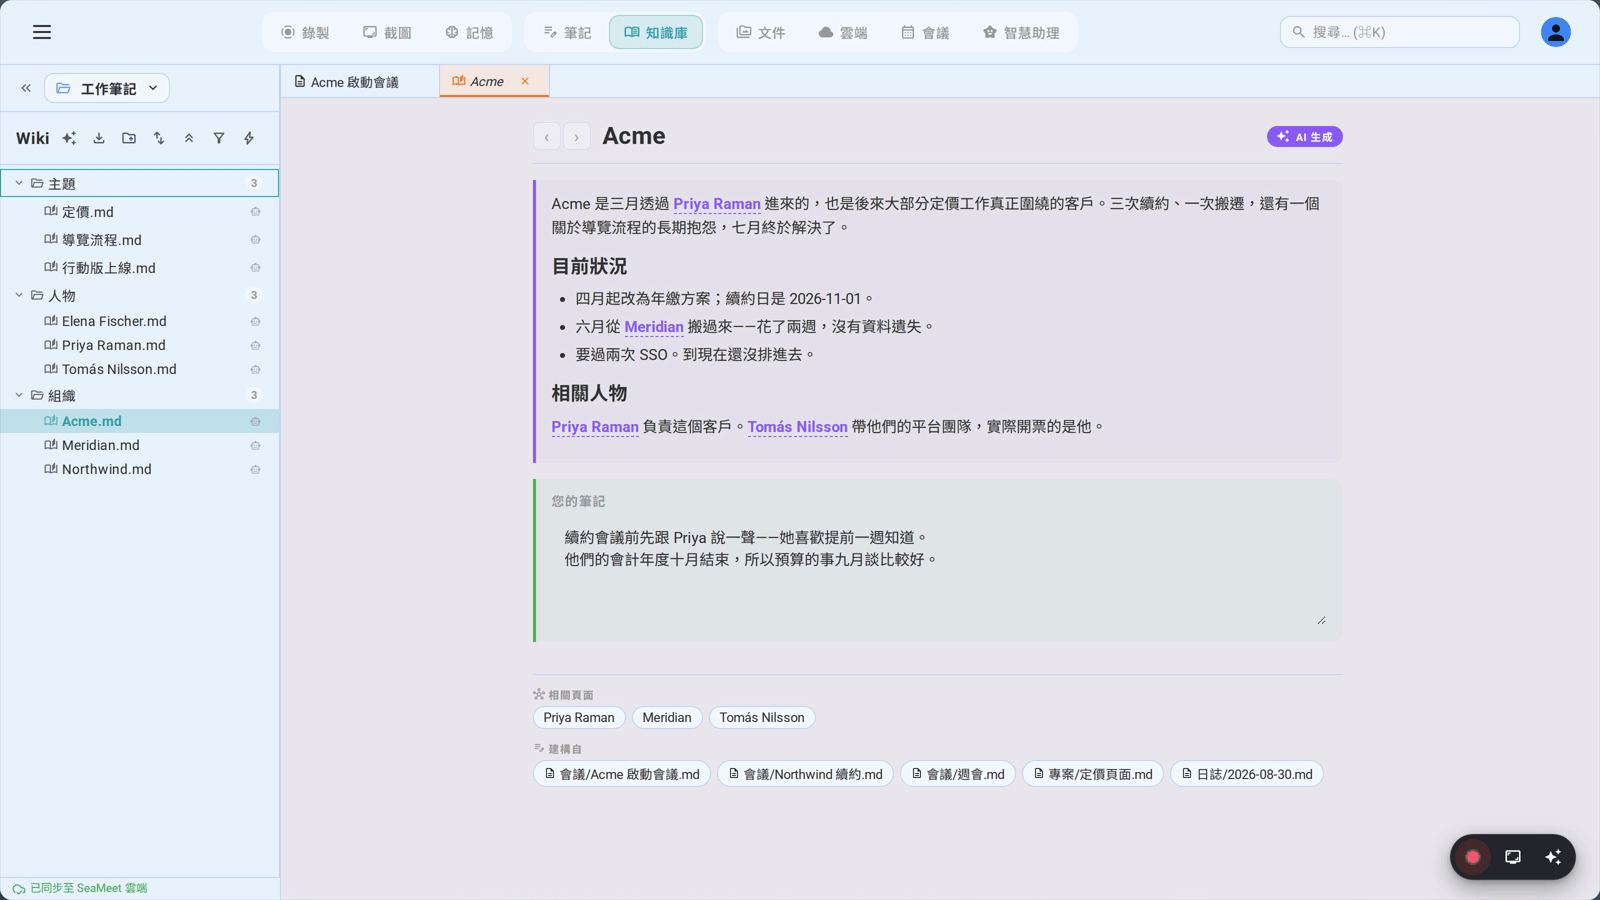
Wiki 表面是這些頁面變成檔案的那一半。Memory 頁面以純 markdown 同步進你自己的資料夾樹,和你自己的筆記並排。把 SeaMeet 指向那個資料夾,它會把整批筆記收斂成 wiki 頁面——每一頁都帶著「來源」列,列出它是從哪些筆記提煉出來的,任何一句話都對得回出處。
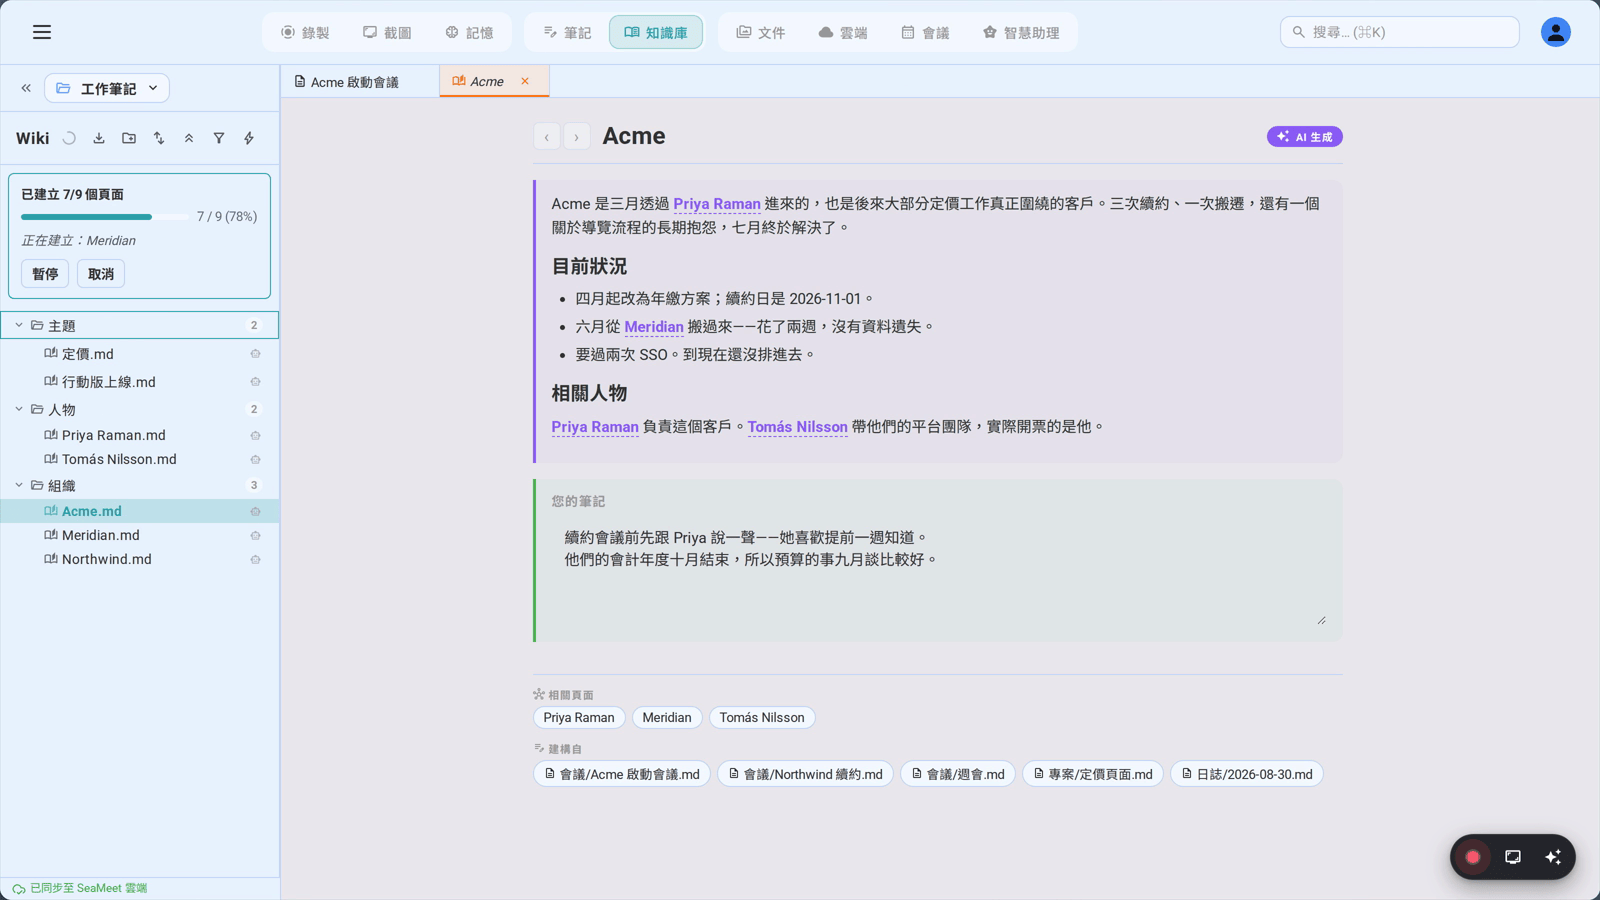
一座自己長的 wiki 能不能被信任,取決於兩個細節。第一是更正:AI 寫錯一句話時,你把它選起來、寫下正確的內容,這個更正會被當成事實留著——頁面會繞著它改寫,而不是把它輾過去。第二是界線:每一頁都有一塊只屬於你的區域。AI 維護它自己的區塊,永遠不碰你在下方寫的東西。工作區也把宇宙隔開——副業永遠不會和公司文件共用同一份索引。
筆記、逐字稿、wiki:你到底需要哪一層
三層都值得留,因為它們回答不同的問題:
| 層 | 回答的問題 | 組織方式 | 會不會過期 |
|---|---|---|---|
| 逐字稿 | 當時到底說了什麼? | 時間與說話者 | 不重讀,但永遠查得到 |
| 會議筆記 | 那場會我們決定了什麼? | 會議 | 到下一場會議為止 |
| 會議知識庫 | 關於某公司、某主題、某個人——現在的事實是什麼? | 主題 | 自己更新 |
逐字稿是你的事實基礎和稽核線索。筆記是當天的工作本。只有 wiki 這一層,是為了一個月後才來的提問而生的——而重要的問題,多半都是那時候才來。
任何會議都能餵養它,因為沒有東西需要加入
一座只收正式視訊會議的 wiki,是一座有洞的 wiki。撐起一家公司的對話,越來越多發生在會議機器人到不了的地方——通訊軟體、電話、會議室本身。因為 SeaMeet 是從你這一側的螢幕與喇叭錄,這些全部都是 wiki 的原料:Google Meet 上的策略會議,和 WhatsApp 上的談判,待遇完全相同——先從一場錄音開始,轉逐字稿、抽取、更新頁面。
筆記本型的助理也注意到了同樣的拉力——Granola 已經把 memory 掛在它的筆記旁邊行銷。但一座只從「有人在會中打下的字」長出來的記憶,繼承的是記錄者的盲點。把兩種做法擺在一起比較,值得你花十分鐘再決定把團隊的記憶交給誰。
費用
知識庫不是被牆起來的進階功能。任何錄音的前 15 分鐘完全不用註冊;免費方案含六小時逐字稿、永久有效;Sync Pro 解除長度限制,月繳 $15.99,年繳方案每月 $12.99。
FAQ
會議知識庫只是會議筆記的新名字嗎?
不是——差別在組織的單位。筆記是一場會一份、會後就凍結;會議知識庫是一個主題一頁,而且隨新會議進來持續編輯。筆記是知識庫讀進去的原料,兩者是並存的關係。
有什麼東西會加入我的會議嗎?
沒有任何東西會加入任何會議。錄音發生在你的機器上,參與者清單不會多出機器人,也不會發出任何邀請。這也是為什麼這座 wiki 連會議機器人在結構上到不了的通話都收得到——通訊軟體通話、電話、面對面會議。
支援哪些 app、哪些類型的會議?
你團隊實際開會的每一種:瀏覽器裡的會議、桌面版會議軟體、通訊軟體通話、一般電話與實體會議室,外加事後帶進來的音訊與影片檔。一座 wiki,全部一起長。
支援哪些語言?
逐字稿涵蓋 20+ 種語言、自動偵測,包含一句話裡混用兩種語言的情境。Memory 頁面與每週摘要跟著會議使用的語言走。
AI 偶爾會寫錯,那怎麼辦?
你來更正。把錯的那句選起來、寫下對的內容,更正會被存為事實——頁面繞著你的修正改寫,不會重複犯錯;而透過「來源」列,原始筆記永遠點一下就到。
我的檔案到底存在哪裡?
存在你可以在任何地方打開的格式裡。Memory 頁面以純 markdown 同步進你的資料夾樹,錄音與逐字稿都能匯出成通用格式。這座 wiki 是你擁有的檔案,不是你租來的資料庫。
看看 Meeting Memory